


W tym zestawieniu porównujemy pięć narzędzi, z których korzystają specjaliści SEO w 2026 roku. Dla większości sklepów i serwisów firmowych wystarczy Screaming Frog. Raport dla zarządu lepiej przygotujesz w Sitebulbie, a przy setkach tysięcy adresów sięgniesz po crawler w chmurze.
Czym jest crawler i czym różni się od Googlebota?
Crawler SEO to program, który przechodzi przez witrynę tak jak robot wyszukiwarki. Zaczyna od strony głównej albo listy adresów, pobiera kod HTML, zapisuje kod odpowiedzi serwera i idzie dalej po każdym znalezionym linku. Po kilku minutach albo kilku godzinach masz pełną mapę serwisu: które strony istnieją, jak są ze sobą połączone i co zwracają.
Googlebot robi to samo, ale z innym celem. Jego zadaniem jest indeksowanie strony, a crawler SEO tylko diagnozuje. Różnica ma znaczenie praktyczne. Googlebot ma ograniczony budżet crawlowania i sam decyduje, które adresy odwiedzi. Twój crawler przejdzie po wszystkim, na co mu pozwolisz, więc pokaże też strony, do których Google nigdy nie dociera.
Drugą różnicą jest renderowanie. Googlebot przepuszcza stronę przez Web Rendering Service (WRS), czyli wyszukiwarkową wersję przeglądarki Chromium, która wykonuje JavaScript. Crawler SEO domyślnie czyta surowy HTML. Tryb renderowania JS trzeba w nim włączyć samodzielnie, o czym za chwilę.
Co sprawdzi crawler w audycie technicznym?
Crawler pokrywa tę część zakresu audytu technicznego, która dotyczy samej struktury strony. Pełną listę obszarów audytu znajdziesz we wpisie o audycie technicznym SEO. Narzędzie wykrywa błędy 404 i 5xx, pętle oraz łańcuchy przekierowań, strony z tagiem noindex i adresy zablokowane w robots.txt. Z tej samej bazy odczytasz meta title, opis, nagłówek H1 i adres kanoniczny każdej podstrony.
Crawl pokazuje też architekturę. Widzisz głębokość kliknięć, czyli liczbę kroków od strony głównej, oraz strony osierocone, do których nie prowadzą żadne linki wewnętrzne. Duplikacja treści wychodzi na jaw, gdy kilka adresów ma ten sam tytuł albo prawie identyczny content.
Czego crawler nie pokaże? Prawdziwego zachowania Googlebota i doświadczenia użytkowników na żywym ruchu. Do tego potrzebujesz danych z Google Search Console i logów serwera, o czym niżej.
TOP 5 crawlerów SEO w 2026 roku
Kolejność pokazuje, jak często dane narzędzie przydaje się w typowym audycie sklepu albo serwisu firmowego.
1. Screaming Frog SEO Spider – standard w audycie technicznym
Screaming Frog SEO Spider to aplikacja desktopowa dla systemów Windows, macOS i Linux, z której korzysta większość agencji. Wersja darmowa obsłuży do 500 URL-i w jednym crawlu. Wystarczy na stronę firmową, ale nie na sklep. Licencja na rok kosztuje 245 euro za stanowisko (przy zakupie od jednej do czterech licencji).
Płatna wersja odblokowuje funkcje, dla których kupuje się to narzędzie. Możesz renderować JavaScript i zapisać obok siebie surowy oraz wyrenderowany HTML. Możesz podpiąć Google Search Console, GA4 i PageSpeed Insights, żeby przy każdym adresie widzieć kliknięcia, sesje i wyniki szybkości ładowania. Custom extraction pozwala wyciągnąć z kodu dowolny element, na przykład cenę, dostępność albo dane strukturalne produktu. Crawle zaplanujesz cyklicznie i porównasz ze sobą, co ułatwia monitoring po każdym wdrożeniu.
Minusem jest próg wejścia. Wynik to tabele z dziesiątkami kolumn, a priorytety ustalasz samodzielnie. Przy bardzo dużych serwisach ogranicza Cię też pamięć komputera, choć tryb zapisu do bazy danych przesuwa tę granicę daleko. Analiza logów serwera wymaga osobnego programu tego producenta, Log File Analysera.
2. Sitebulb – crawler, który tłumaczy błędy
Sitebulb crawluje serwis podobnie jak Screaming Frog, ale wynik podaje inaczej. Zamiast surowych tabel dostajesz „Hints”, czyli opisane problemy z priorytetem, wyjaśnieniem i listą adresów. W planie Pro jest ich ponad 300. Do tego interaktywne mapy linkowania i porównanie audytów w czasie.
To dobry wybór, gdy raport trafia do osoby spoza SEO: właściciela sklepu, programisty albo zarządu. Wersja desktopowa kosztuje od 18 USD miesięcznie (Lite) do 42 USD (Pro), a Sitebulb Cloud dla zespołów zaczyna się od 245 USD miesięcznie. Słabiej wypada przy niestandardowych zadaniach: możliwości konfiguracji są mniejsze niż w Screaming Frogu.
3. Ahrefs Site Audit – audyt połączony z danymi o ruchu
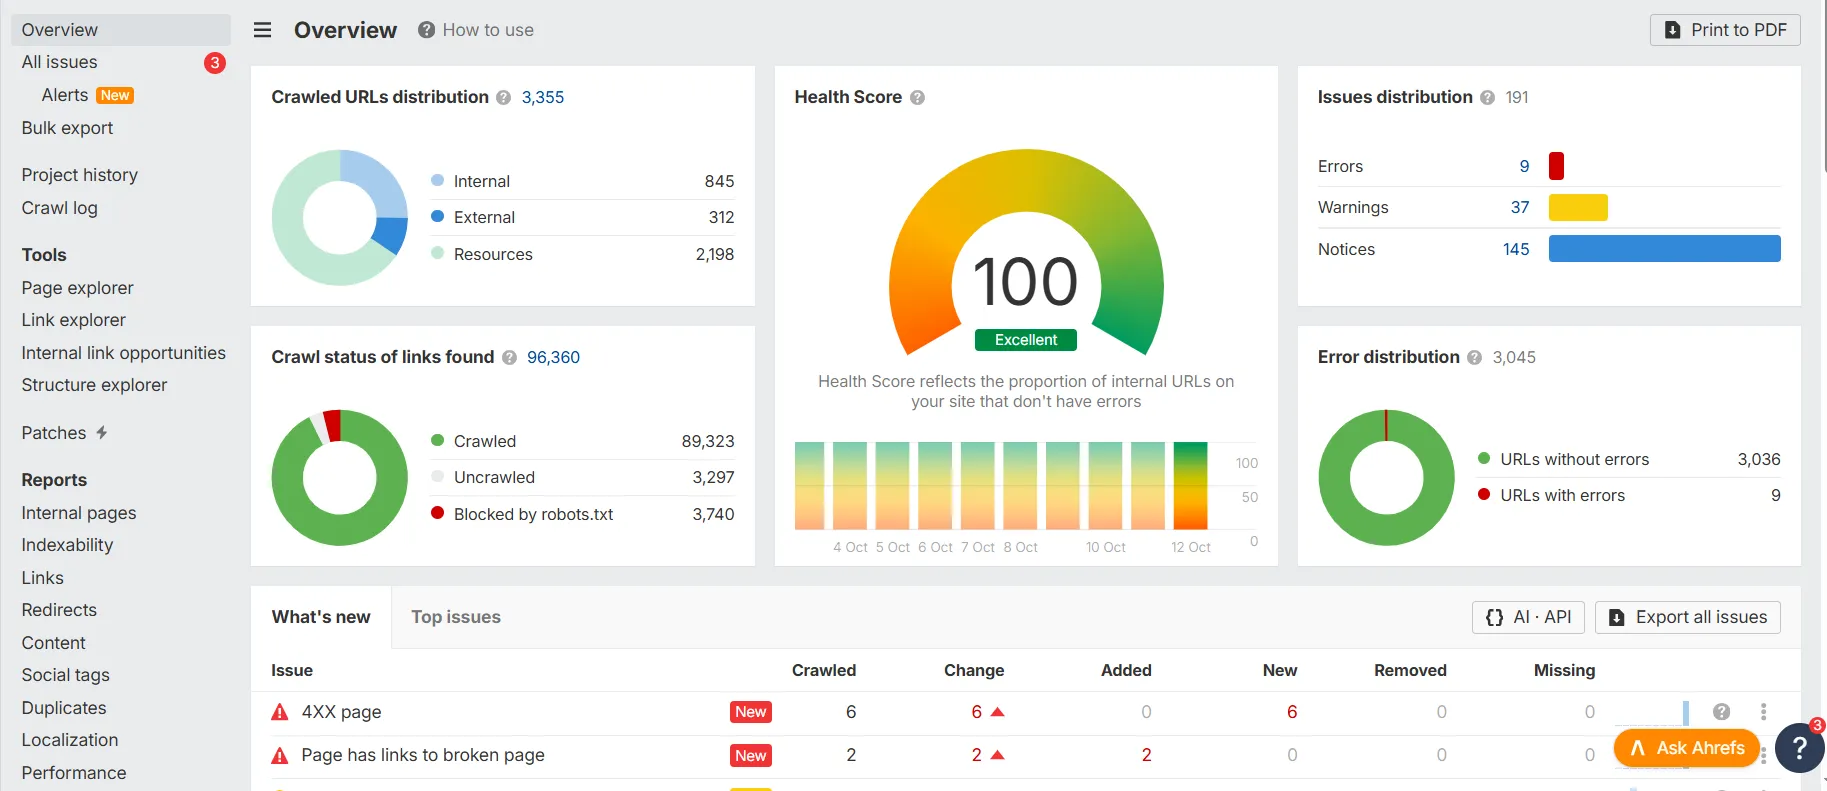
Ahrefs Site Audit to moduł platformy Ahrefs, więc sens ma głównie wtedy, gdy już za nią płacisz. Crawler działa w chmurze, sprawdza ponad 170 typów problemów i przy każdym adresie pokazuje ruch organiczny oraz linki zewnętrzne. Dzięki temu od razu widzisz, czy błąd dotyczy strony, która zarabia, czy martwej podstrony bez ruchu.
Always-on Audit crawluje serwis na bieżąco i wysyła alert, gdy pojawi się nowy problem. Ograniczenia? Limity stron zależą od planu, a konfiguracja crawla jest uboższa niż w narzędziach desktopowych.
4. Semrush Site Audit – prosty start dla marketera
Semrush Site Audit ma najniższy próg wejścia w tym zestawieniu. Podajesz domenę, wybierasz limit stron i po chwili dostajesz Health Score z podziałem na błędy, ostrzeżenia i uwagi. Narzędzie sprawdza ponad 140 elementów, a po wdrożeniu poprawek samo crawluje serwis ponownie.
Nadaje się dla zespołu in-house SEO w mniejszej firmie, który korzysta z Semrusha do słów kluczowych i konkurencji. Specjalista technicznego SEO szybko trafi jednak na sufit: brakuje swobody w ekstrakcji danych i pracy na surowym HTML.
5. JetOctopus – crawler w chmurze z analizą logów
JetOctopus to propozycja dla dużych sklepów e-commerce i portali, w których liczba adresów idzie w setki tysięcy. Crawl odbywa się na serwerach dostawcy, więc nie ogranicza Cię komputer, a ten sam panel przyjmuje logi serwera. Zestawiasz wtedy to, co jest na stronie, z tym, co realnie odwiedza Googlebot.
Cena zależy od limitu stron i modułu logów, więc przy małej witrynie przepłacisz. Alternatywy w tej klasie to Lumar (dawniej DeepCrawl), Oncrawl i Botify, kierowane głównie do dużych firm.
Porównanie crawlerów: który wybrać?
Crawlery desktopowe i chmurowe różnią się tym, co ogranicza skalę crawla. Screaming Frog i Sitebulb w wersji desktopowej pracują na Twoim komputerze: płacisz za licencję, a liczbę adresów, które przejdziesz, wyznacza pamięć RAM i miejsce na dysku. Ahrefs, Semrush i JetOctopus crawlują na serwerach dostawcy, więc komputer nie ma znaczenia, ale limit stron zależy od abonamentu. W zamian dostajesz cykliczne crawle i alerty bez uruchamiania programu.
| Narzędzie | Typ | Darmowy limit | Renderowanie JS | Analiza logów | Cena (październik 2026) | Dla kogo |
|---|---|---|---|---|---|---|
| Screaming Frog SEO Spider | desktop | 500 URL-i | tak, w licencji | osobny program | 245 euro rocznie | specjaliści SEO, agencje, sklepy |
| Sitebulb | desktop i chmura | okres próbny | tak | nie | od 18 USD/mies. | raporty dla klienta i zarządu |
| Ahrefs Site Audit | chmura | ograniczony | tak | nie | w abonamencie Ahrefs | firmy z Ahrefsem, stały monitoring |
| Semrush Site Audit | chmura | ograniczony | tak | nie | w abonamencie Semrush | marketerzy, małe zespoły |
| JetOctopus | chmura | okres próbny | tak | tak, w panelu | wycena wg limitu stron | duże e-commerce i portale |
Masz sklep do 50 tysięcy adresów i chcesz robić audyt samodzielnie? Kup licencję Screaming Froga. Raport musi zrozumieć ktoś bez wiedzy technicznej? Dołóż Sitebulb. Płacisz już za Ahrefs albo Semrush? Ustaw w nim stały monitoring, a głębsze analizy rób crawlerem desktopowym. JetOctopus albo Lumar rozważ dopiero przy serwisie, którego nie przejdziesz na jednym komputerze, albo gdy analiza logów ma być stałą częścią pracy.
Renderowanie JavaScript: crawl oczami Googlebota i botów AI
Sklepy na nowoczesnych szablonach i aplikacje napisane w Reakcie, Vue czy Angularze dociągają część treści skryptami. Opisy, linki do produktów, a czasem nawet tag canonical pojawiają się dopiero po wykonaniu JS. Crawl samego HTML takich elementów nie zobaczy.
Dlatego w audycie robisz dwa przebiegi. Pierwszy bez renderowania, drugi z włączonym renderowaniem JavaScript. W Screaming Frogu ustawiasz to w Configuration → Spider → Rendering. Różnice między wynikami to lista elementów, które istnieją tylko po stronie przeglądarki: brakujące linki wewnętrzne, puste nagłówki, dane strukturalne dodawane przez skrypt.
W 2026 roku ten test ma drugie znaczenie. Googlebot renderuje strony w swoim Web Rendering Service, ale GPTBot, ClaudeBot czy PerplexityBot czytają przede wszystkim surowy HTML (badanie Vercel i MERJ). Treść widoczna tylko po renderze może więc w ogóle nie trafić do odpowiedzi czatów AI. Crawl bez JS z user-agentem bota AI pokaże, co z Twojej witryny trafia do tych systemów, a plik robots.txt powie, czy w ogóle je wpuszczasz. Szerzej piszemy o tym przy okazji audytu AI Search.
Jak przeprowadzić crawl sklepu e-commerce, żeby nie zebrać śmieci?
Sklep internetowy potrafi wygenerować więcej adresów, niż ma produktów. Każdy filtr, sortowanie i parametr śledzący tworzy nowy URL. Crawler z domyślnymi ustawieniami zbierze ich dziesiątki tysięcy i zamiast audytu dostaniesz raport z duplikatów, które przesłonią prawdziwe problemy.
Zanim klikniesz „Start”, ogranicz zakres. Wyklucz parametry sortowania i paginacji wyrażeniami regularnymi, a jeśli chcesz sprawdzić tylko kategorie, wczytaj listę adresów z mapy witryny zamiast pełnego przejścia po linkach. Ustaw prędkość dopasowaną do serwera: na hostingu współdzielonym zacznij od 2–3 zapytań na sekundę. Zbyt szybki crawl może spowolnić sklep klientom, a odpowiedzi 429 albo 503 zafałszują wyniki.
W PrestaShopie i WooCommerce warto od razu sprawdzić trzy miejsca. Warianty produktu bywają osobnymi adresami bez wspólnego adresu kanonicznego. Filtry warstwowe tworzą indeksowalne kombinacje, które powinny mieć noindex albo blokadę w robots.txt. Stare kategorie po zmianach w ofercie kończą się błędem 404 lub łańcuchem przekierowań, a linki z menu wciąż do nich prowadzą. Crawler pokaże wszystkie trzy w jednym raporcie, jeśli dobrze ustawisz jego zakres.
Crawler w praktyce: logi, GSC, Core Web Vitals i migracja
Analiza logów serwera
Crawl mówi, co jest na stronie. Logi serwera mówią, co z tego odwiedził robot Google. Każde zapytanie Googlebota zostaje w pliku z datą, adresem i kodem odpowiedzi. Z analizy logów dowiesz się, które sekcje bot odwiedza codziennie, a których nie widział od miesięcy, oraz czy marnuje czas na adresy z parametrami i stare przekierowania. Przy dużych serwisach to najmocniejszy dowód w całym audycie, bo pokazuje zachowanie wyszukiwarki, a nie symulację.
Dane z Google Search Console
Raport indeksowania w GSC uzupełnia crawl o decyzje Google: które strony zostały odrzucone, uznane za duplikat albo wykryte, ale niezaindeksowane. Integracja Screaming Froga z Search Console dokłada te informacje do każdego adresu, więc widzisz błąd i jego skutek w jednym wierszu.
Core Web Vitals i szybkość ładowania
Crawler z podpiętym PageSpeed Insights zmierzy LCP, INP i CLS dla wybranych adresów, ale to dane laboratoryjne. Dane terenowe o doświadczeniach użytkowników znajdziesz w raporcie Core Web Vitals w GSC.
Migracja i monitoring po wdrożeniu
Przy migracji sklepu crawler przydaje się dwa razy. Przed przenosinami crawlujesz starą domenę i zapisujesz pełną listę adresów. Po starcie nowej wersji wczytujesz tę listę w trybie List i sprawdzasz, czy każdy stary URL przekierowuje kodem 301 na właściwy odpowiednik, bez łańcuchów i bez lądowania na stronie głównej. Kolejny crawl po tygodniu wychwyci to, co wdrożenie zepsuło po drodze.
Checklista crawla przed oddaniem raportu
Zanim przekażesz raport dalej, przejdź tę listę. Każdy punkt sprawdzisz w jednym z opisanych narzędzi.
- Zakres crawla wyklucza parametry sortowania, filtrów i śledzenia.
- Masz dwa przebiegi: bez renderowania i z renderowaniem JavaScript.
- Lista błędów 404 i 5xx zawiera źródła linków, które do nich prowadzą.
- Przekierowania nie tworzą łańcuchów ani pętli.
- Każda indeksowalna strona ma poprawny adres kanoniczny.
- Nagłówki H1, opisy i meta title nie powtarzają się na wielu adresach.
- Robots.txt nie blokuje zasobów potrzebnych do renderowania ani botów, które chcesz wpuścić.
- Ważne podstrony leżą najwyżej trzy kliknięcia od strony głównej.
- Crawl ma podpięte dane z Google Search Console, żeby przy każdym błędzie było widać ruch.
- Crawl uruchomiony z user-agentem Googlebota i bota AI daje te same wyniki co domyślny.
- Wyniki są zapisane, żeby porównać je z kolejnym crawlem po wdrożeniu poprawek.
Najczęstsze pytania o crawlery SEO
Czy darmowa wersja Screaming Frog wystarczy do audytu?
Do strony firmowej mieszczącej się w 500 adresach – tak. Sklep przekroczy ten limit już na samych kartach produktów. Darmowa wersja nie renderuje też JavaScriptu i nie łączy się z GSC ani GA4, więc przy poważniejszym audycie licencja zwraca się po pierwszym projekcie.
Jak często crawlować sklep internetowy?
Pełny crawl raz w miesiącu i dodatkowo po każdej większej zmianie: aktualizacji szablonu, nowym module filtrów, migracji. Stały monitoring w Ahrefsie albo Semrushu wyłapie nagłe awarie między pełnymi przebiegami.
Czy crawler może obciążyć serwer?
Może, jeśli wyślesz kilkadziesiąt zapytań na sekundę do serwera na słabym hostingu. Ustaw limit prędkości, crawluj poza godzinami szczytu sprzedaży i uprzedź administratora, żeby nie zablokował Twojego adresu IP, uznając ruch za atak.
Screaming Frog czy Sitebulb?
Screaming Frog daje więcej kontroli i lepiej sprawdza się w diagnostyce. Sitebulb szybciej prowadzi do wniosków i lepiej wygląda w raporcie dla klienta. Wiele agencji używa obu.
Od którego crawlera zacząć w 2026 roku?
Zacznij od darmowej wersji Screaming Froga na fragmencie serwisu i sprawdź, ile błędów znajdziesz w pierwszej godzinie. Jeśli lista szybko rośnie, kup licencję albo zleć profesjonalny audyt techniczny, w którym crawl łączymy z logami serwera, danymi z Google Search Console i pomiarami Core Web Vitals. Narzędzie znajdzie problemy, ale o widoczności sklepu w wyszukiwarce decyduje to, czy poprawki faktycznie trafią do wdrożenia.